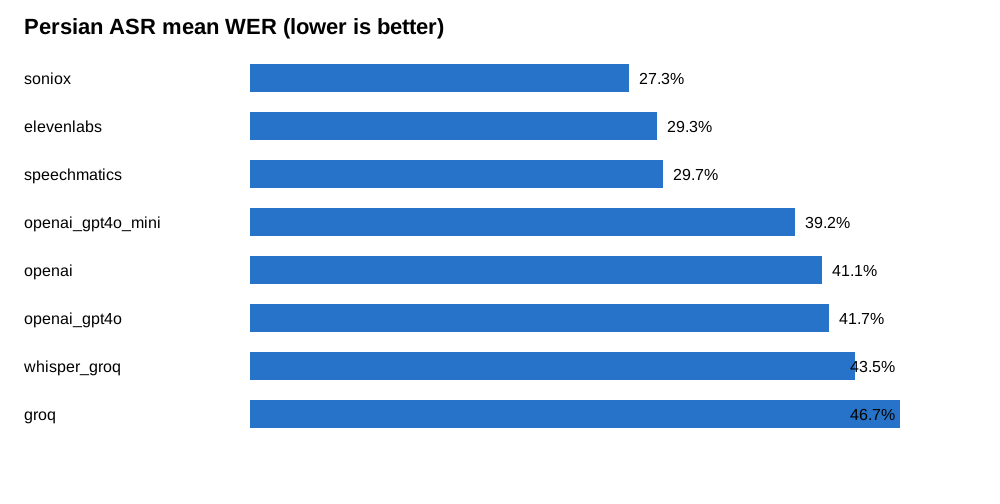
اگر میخواهید برای فارسی از تبدیل گفتار به متن استفاده کنید، انتخاب مدل فقط به نام سرویس ختم نمیشود. باید بدانید با فایل کار میکنید یا پخش زنده، داده را به سرویس بیرونی میفرستید یا روی زیرساخت خودتان نگه میدارید، و هزینه را بر چه واحدی میپردازید.
این راهنما نقشهٔ انتخاب است؛ عددهای کیفیت و هزینهٔ واقعی را در صفحهٔ زندهٔ بنچمارک میبینید.
نقشهٔ انتخاب در یک دقیقه
برای محصولی که باید سریع راه بیفتد، APIهای مدیریتشده معمولاً سادهترین مسیرند. برای دادهٔ حساس یا هزینهٔ قابلکنترل در مقیاس بالا، مدلهای خودمیزبان انتخاب بهتری هستند؛ در عوض باید GPU، صف، مانیتورینگ و نگهداری را خودتان اداره کنید.
مدلها و سرویسهای اصلی
OpenAI: چند مسیر با یک اکوسیستم
gpt-4o-transcribe برای رونویسی فایل، gpt-4o-mini-transcribe برای هزینهٔ کمتر، و gpt-4o-transcribe-diarize برای سناریوهای چندگوینده مناسباند. Whisper هم مسیر قدیمیتر و قابلحمل اکوسیستم OpenAI است. این گزینهها API هستند و برای اجرای واقعی باید محدودیت حجم، صف و هزینهٔ دقیقهای را در نظر گرفت.
Gemini و مدلهای صوتی چندوجهی
Gemini میتواند صوت را در کنار متن و دیگر ورودیها تحلیل کند. مزیت اصلی آن در سناریوهایی است که بعد از رونویسی، خلاصهسازی یا استخراج ساختاری هم لازم دارید؛ برای مقایسهٔ صرفاً ASR باید خروجی و زمان را با قرارداد یکسان بسنجید.
Soniox: realtime و چندزبانه
Soniox برای جریان زنده، تشخیص زبان و ساختن متن تدریجی جذاب است. در benchmark باید time to first token، تأخیر قطعهها و پایداری اتصال را جدا از کیفیت نهایی ثبت کرد؛ پاسخ نهایی تنها بخشی از تجربهٔ realtime است.
Speechmatics: کیفیتهای قابل انتخاب
Speechmatics یک ردیف واحد نیست: Melia 1 برای batch و گزینههای Standard و Enhanced برای سطحهای متفاوت هزینه و کیفیت عرضه میشوند. در جدول باید operating point، batch یا realtime و نرخ همان مسیر کنار نام مدل ذخیره شود؛ مقایسهٔ یک نرخ با همهٔ کیفیتها گمراهکننده است.
ElevenLabs Scribe
Scribe برای فایل و realtime ارائه میشود و وقتی محصول صوتی شما از قبل با اکوسیستم ElevenLabs کار میکند، یک گزینهٔ عملی است. قیمت و latency حالت فایل و زنده را جدا بنویسید.
Grok Transcriber و مسیرهای تازه
سرویسهای تازهای مثل Grok Transcriber ارزش رصد کردن دارند، اما تا وقتی endpoint، قیمت و نمونهٔ قابلتکرار نداشته باشند، نباید عددشان را با نتیجهٔ قطعی مدلهای دیگر یکی کرد. در benchmark وضعیت «قابلآزمایش نیست» هم دادهٔ معتبر است.
Whisper خودمیزبان
Whisper با faster-whisper و مدلهای large-v3 یک baseline جدی برای اجرای محلی است. مزیت آن کنترل داده و امکان بهینهسازی است؛ هزینهٔ واقعی شامل GPU، زمان بیکاری، ذخیرهسازی و عملیات است، نه فقط قیمت صفر API.
Shenava و مدلهای فارسی باز
Shenava از خانوادهٔ مسیرهای فارسیِ خودمیزبان است و برای مقایسهٔ کیفیت، اندازهٔ مدل و هزینهٔ اجرا ارزش دارد. باید model card، مجوز، نسخه، hash و دادهٔ ارزیابی ثبت شود تا نتیجه قابل بازتولید باشد.
Qwen3-ASR و مدلهای جامعه
مدلهایی مثل Qwen3-ASR میتوانند برای آزمایش روی GPU و مقایسهٔ سرعت مفید باشند. عدد پارامتر بهتنهایی کیفیت را تعیین نمیکند؛ tokenizer، زبانهای پوششدادهشده، quantization و طول صوت هم باید در گزارش بیاید.
Vira Avangaar و بازارچههای منطقهای
Vira Avangaar نمونهای از API منطقهای است. برای آن علاوه بر WER و CER، دسترسی شبکه، سقف فایل، گزینههای diarization، punctuation و زمان صف را ثبت میکنیم تا مقایسه فقط به نام مدل محدود نشود.
چه زمانی کدام مسیر را انتخاب کنیم؟
Realtime تعاملی: Soniox، Speechmatics realtime یا ElevenLabs realtime را با time to first token و پایداری قطعهها بسنجید. فایلهای دقیق و چندگوینده: مسیرهای OpenAI، Speechmatics و سرویسهای دارای diarization را مقایسه کنید. دادهٔ حساس یا حجم بالا: Whisper، Shenava و Qwen را با هزینهٔ GPU و ظرفیت همزمانی حساب کنید.
اعداد را چگونه منصفانه بخوانیم؟
WER نرخ خطای واژه است و CER نرخ خطای نویسه؛ هر دو فاصلهٔ ویرایشی خروجی و متن مرجع را نسبت به اندازهٔ متن مرجع گزارش میکنند، اما واحدشان فرق دارد. کنار کیفیت، latency، real-time factor، throughput، هزینهٔ استاندارد هر دقیقه، پشتیبانی زبان، diarization و امکان self-host را ثبت کنید.
برای مقایسهٔ هزینه، نرخهای ساعتی را به دلارِ هر دقیقهٔ صوت تبدیل کنید. برای مدل خودمیزبان هم زمان GPU را با نرخ اجرای همان GPU قیمتگذاری کنید؛ «رایگان» فقط وقتی معنا دارد که هزینهٔ زیرساخت را جداگانه گزارش کرده باشید.
این راهنما و بنچمارک چگونه به هم وصلاند؟
راهنما میگوید هر مسیر برای چه مسئلهای ساخته شده است. صفحهٔ بنچمارک همان مسیرها را روی فایلهای واقعی، با خروجی خام، زمان اجرا، WER، CER، هزینه و وضعیت endpoint میسنجد. با اضافه شدن مدل جدید، همین قرارداد داده اجازه میدهد آن را به جدول و نمودار اضافه کنیم.
ادعای بهتر بودن یک مدل بدون فایل آزمون، نسخه، قیمت و روش اندازهگیری، هنوز نتیجهٔ قابل اتکا نیست.


No comments yet